这个系列讲怎么让 Transformer 训练在 GPU 上跑得更快。这一篇先打基础:第 1 节介绍 GPU 的硬件,包括数据存在哪几层、一个 SM 里有什么、CUDA 的执行层级怎么对应到硬件;第 2 节用四个例子介绍 Triton,后面两篇的 kernel 都用它写。TPU 和 GPU 的对照放在附录 A。
下一篇谁偷走了 5090 的算力和显存用这些知识在 RTX 5090 上拆解一步训练的时间和显存,第三篇 FlashAttention 1–4 讲 attention 的 IO-aware kernel。
环境:RTX 5090 32 GB,torch 2.11.0+cu130,Triton 3.6.0。
1 GPU:越靠近计算单元越快#
做性能分析时最常用的两个数是峰值算力和显存带宽。一个 kernel 受哪个限制,取决于它要搬多少数据、数据在哪一层被读写。这一节按这个顺序看 5090 的硬件:先看数据存在哪几层(1.1),再看负责计算的 SM 里有什么(1.2)。这两节只讲硬件。最后看软件:CUDA 的 thread、warp、block 怎么落到这些硬件上,一个 SM 上同时驻留多少 warp,怎么在等数据时不让计算单元闲着(1.3)。
1.1 存储层级:越近越快,也越小#
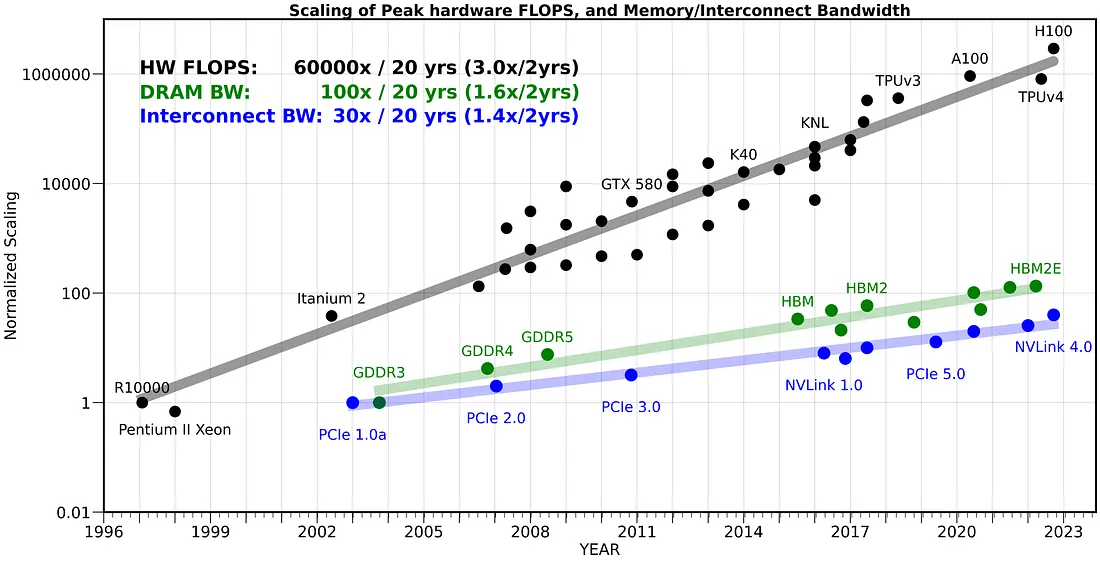
处理器的频率早就不怎么涨了,算力的增长主要来自并行:更多的 SM、更宽的 Tensor core。显存带宽的增长比算力慢得多:过去 20 年,峰值算力涨了约 6 万倍(每两年 3.0 倍),DRAM 带宽只涨了约 100 倍(每两年 1.6 倍),芯片之间的互联带宽约 30 倍(图 1-1)。所以越来越多的 op 落在 roofline 的斜坡上,这是 memory-bound 越来越常见的原因。带宽跟不上,就只能少搬:让读进来的数据留在离计算单元近的地方,多用几次。
数据离计算单元越近,读写越快,容量也越小(图 1-2)。每个 SM 里有 register 和 L1 / shared memory,所有 SM 共享芯片上的 L2,显存在芯片外面。写 kernel 时,L1 和 L2 由硬件当作 cache 自动管理;能自己安排的只有 shared memory(以及 register)。所以 kernel 优化的套路都是一样的:把一块数据从显存读进 shared memory 或 register,在片上尽量多算几次,再写回去。第 2 节的分块矩阵乘、下一篇里的算子融合和之后的 FlashAttention 都是这个思路。
5090 是消费级显卡,显存用的是 GDDR7(32 GB,512-bit,28 Gbps,带宽 1,792 GB/s),不是数据中心卡上的 HBM,也没有 ECC 和 NVLink。
register 和 L1 / shared memory 都在 SM 里面,下面看 SM 本身的结构。
1.2 一个 SM 里有什么#
每个 SM 分成 4 个 SMSP(SM sub-partition),每个 SMSP 有自己的 warp 调度器、register、32 个 CUDA core(FP32 运算单元)和一个 Tensor core,4 个 SMSP 共享一块 L1 / shared memory(图 1-3)。几代 GPU 的规格对比见表 1-1。
| A100 | H100 | B200 | RTX 5090 | |
|---|---|---|---|---|
| SM 数 | 108 | 132 | 148 | 170 |
| L2 | 40 MB | 50 MB | — | 96 MB |
| 显存 | 80 GB HBM2e | 80 GB HBM3 | 192 GB HBM3e | 32 GB GDDR7 |
| 显存带宽 | 2.0e12 B/s | 3.35e12 B/s | 8e12 B/s | 1.79e12 B/s |
| 每 SM 的 CUDA core(FP32) | 64 | 128 | 128 | 128 |
| 每 SM 的 Tensor core | 4 | 4 | 4 | 4 |
| 每 SM 的 L1 + shared | 192 KB | 256 KB | 256 KB | 128 KB |
| 每 SM 的 register | 256 KB | 256 KB | 256 KB | 256 KB |
| 每 SM 的 SMSP(warp 调度器) | 4 | 4 | 4 | 4 |
来自 NVIDIA 各代架构白皮书和产品规格(A100 80GB SXM,H100 SXM)。B200 的 L2 没有找到可靠的公开数字,暂缺。
这些是硬件提供的资源。register 按 thread 分配,shared memory 按 block 分配,要知道一个 kernel 怎么用这些资源,得先看 CUDA 怎么把线程组织起来。
1.3 编程模型:thread、warp、block、grid#
CUDA 的执行模型叫 SIMT(single instruction, multiple threads):同一个 warp 里的 32 个线程在同一时刻执行同一条指令。线程分四层:thread;warp,32 个 thread;block(也叫 CTA),若干个 warp;grid,一次 kernel 启动的全部 block。图 1-4 把四层画在一起,左边逐层放大,右边是每层跑在哪个硬件上。
block 放到 SM 上以后就一直驻留,直到它的线程全部跑完。一个 SM 能同时驻留多少,有几条硬件上限(表 1-2)。warp 的上限分摊到每个 SMSP 的调度器;block 的上限记在整个 SM 上,因为一个 block 的 shared memory 和同步由 4 个 SMSP 共用。
| A100 | H100 | B200 | RTX 5090 | |
|---|---|---|---|---|
| 每 SMSP 最多驻留 warp | 16 | 16 | 16 | 12 |
| 每 SM 最多驻留 warp | 64 | 64 | 64 | 48 |
| 每 SM 最多驻留 block | 32 | 32 | 32 | 24 |
| 每 thread 最多 register | 255 | 255 | 255 | 255 |
来自 CUDA Programming Guide 的 compute capability 表(8.0、9.0、10.0、12.0)。
一个 block 的 warp 按编号轮流分到 4 个 SMSP:warp 0 到 SMSP 0,warp 1 到 SMSP 1,依此类推。驻留不等于在跑。一个 warp 等显存数据要几百个周期,这段时间里调度器改发另一个就绪的 warp;所有驻留 warp 的 register 一直留在 register file 里,换 warp 不用保存或恢复状态。所以一个 SM 上同时驻留的 warp 越多,访存延迟越容易藏住。图 1-5 画的是驻留 3 个 block、每个 4 个 warp 时的某一拍:每个 SMSP 有 3 个 warp,分别来自 3 个 block,调度器每个周期只发射其中一个;SMSP 2 的 3 个都在等数据,这一拍就空转。
驻留几个 warp 才够、在 Triton 里怎么调,放到 2.5 节 写 kernel 时再看。
block 之间不能直接共享数据,只能通过显存交换,而这正是最慢的一层。所以要尽量把会重复读的数据放进同一个 block 里处理,这就是分块(tiling)。在 CUDA 里分块要自己管 shared memory 和线程同步,第 2 节的 Triton 把这部分交给编译器。
2 Triton:按 block 写 kernel#
Triton 按 block 写 kernel,正好对应 1.3 节说的分块。CUDA 要写清楚每个线程做什么,控制最细,但 shared memory、线程同步这些都要自己管。Triton 只要写清楚每个线程块做什么:把一块数据读进来,在片上算完,再写回显存,块内怎么分给线程、要不要经过 shared memory 由编译器决定。Triton 把一个线程块叫作一个 program,概念对应见表 2-1。
| CUDA | Triton | 写法 | 能否直接控制 |
|---|---|---|---|
| thread | 不暴露 | 写不到 threadIdx | 不能 |
| warp | 只给数量 | 启动时传 num_warps=N,默认 4 | 只能调数量 |
| block(CTA) | program | @triton.jit 函数体就是一个 program 的代码;tl.program_id(axis) ≈ blockIdx,tl.num_programs(axis) ≈ gridDim | 主要的编程层 |
| grid | grid | kernel[grid](...),例如 grid = (triton.cdiv(n, BLOCK),) | 自己定 |
| shared memory | 由编译器分配 | 没有对应语句 | 不能 |
下面四个例子由浅入深:逐元素的 GELU,一行一个 program 的 softmax,行太长时分块累加的 row sum,以及分块乘加的矩阵乘;最后一节看每个 program 该用几个 warp。代码都在 RTX 5090 上和 PyTorch 对照过。下一篇手写的融合 RMSNorm 和之后的 FlashAttention 也都用 Triton 写。
2.1 GELU:逐元素 kernel#
逐元素 op 最简单,每个元素各算各的,program 之间不需要配合。把 n 个元素切成每段 BLOCK 个,一段交给一个 program(图 2-1)。kernel 里先用 tl.program_id 算出自己负责的下标,读进来,算完写回:
@triton.jit
def gelu_kernel(x_ptr, y_ptr, n, BLOCK: tl.constexpr):
    pid = tl.program_id(axis=0)               # 第几个 program(≈ CUDA 的 blockIdx.x)
    offsets = pid * BLOCK + tl.arange(0, BLOCK)  # 这个 program 负责的 BLOCK 个下标
    mask = offsets < n                        # 最后一个 program 可能越界
    x = tl.load(x_ptr + offsets, mask=mask)   # 从显存读到 register
    # tanh 近似:0.5·x·(1 + tanh(√(2/π)·(x + 0.044715·x³))),tanh(a) = (e^{2a} − 1)/(e^{2a} + 1)
    a = 0.79788456 * (x + 0.044715 * x * x * x)
    e = tl.exp(2 * a)
    y = 0.5 * x * (1 + (e - 1) / (e + 1))
    tl.store(y_ptr + offsets, y, mask=mask)   # 写回显存
启动时只要定 grid,也就是 program 的个数。program 个数和 SM 个数无关:5090 有 170 个 SM,program 多于 SM 时,GPU 会一批一批地调度。
def gelu(x):
    y = torch.empty_like(x)
    n, BLOCK = x.numel(), 1024                # 每个 program 处理 1024 个元素
    grid = (triton.cdiv(n, BLOCK),)           # program 个数,不是 SM 个数
    gelu_kernel[grid](x, y, n, BLOCK=BLOCK)
    return y
Triton 会把 kernel 编译成 PTX,PTX 描述的是单个线程的指令。下面是 GELU 的 PTX 节选:
mov.u32        %r17, %ctaid.x;                // program 编号,即 blockIdx.x
mov.u32        %r20, %tid.x;                  // 线程编号
@%p1 ld.global.b32 { %r1 }, [ %rd1 + 0 ];     // 读显存,%p1 是 mask 算出的谓词
...                                           // 一共 8 条 ld.global
ex2.approx.f32 %r72, %r71;                    // tl.exp 编成以 2 为底的指数
@%p1 st.global.b32 [ %rd9 + 0 ], { %r9 };     // 写回显存
一个 program 处理 1024 个元素,默认 4 个 warp 共 128 个线程,所以每个线程分到 8 个元素,PTX 里正好是 8 条 ld.global 和 8 条 st.global。
GELU 的每个元素互不依赖,怎么切都可以。softmax 的每个元素都要用到整行的最大值和总和,切分就得按行来。
2.2 Softmax:一行一个 program#
softmax 在 eager 下要 5 个 kernel,和下一篇里 attention 的 softmax 一样。对 [M, N] 的输入,一共读 5MN + 2M 个数,写 3MN + 2M 个:
def softmax_naive(x):                         # x: [M, N],按行
    m = x.max(dim=1, keepdim=True).values     # 读 MN,写 M
    z = x - m                                 # 读 MN + M,写 MN
    e = torch.exp(z)                          # 读 MN,写 MN
    s = e.sum(dim=1, keepdim=True)            # 读 MN,写 M
return e / s # 读 MN + M,写 MN如果一个 program 处理一整行(图 2-2),max、exp、求和、除都可以在 register 里做完,只读 MN、写 MN,读写量是原来的 1/4:
@triton.jit
def softmax_kernel(x_ptr, y_ptr, stride, N, BLOCK: tl.constexpr):
    row = tl.program_id(0)                    # 一个 program 处理一整行
    cols = tl.arange(0, BLOCK)                # BLOCK ≥ N,一次装下整行
    x = tl.load(x_ptr + row * stride + cols, mask=cols < N, other=float("-inf"))
    x = x - tl.max(x, axis=0)                 # 以下全在 register 里
    e = tl.exp(x)
    y = e / tl.sum(e, axis=0)
    tl.store(y_ptr + row * stride + cols, y, mask=cols < N)

def softmax(x):
    M, N = x.shape
    y = torch.empty_like(x)
    softmax_kernel[(M,)](x, y, x.stride(0), N, BLOCK=triton.next_power_of_2(N))
    return y
在 5090 上对 4096 × 4096 的 fp32 输入实测,eager 版 249 µs,Triton 版 80 µs,快了 3.1 倍,和 torch.softmax(79 µs)相当。
这个写法要求 BLOCK ≥ N,也就是一行能一次装进一个 program。行再长,一个 program 就只能一块一块地读。
2.3 Row sum:行太长时分块累加#
先看最简单的按行归约:求和。program 沿着行一块一块读(图 2-3),每块 TILE 个数加到一个长度为 TILE 的部分和向量上,最后再把这个向量加成一个数。循环里每个位置各加各的,不需要线程之间通信;只有最后的 tl.sum 做一次跨线程归约。
@triton.jit
def row_sum_kernel(x_ptr, out_ptr, N, TILE: tl.constexpr):
    row = tl.program_id(0)
    acc = tl.zeros([TILE], dtype=tl.float32)  # TILE 路部分和,不是一个标量
    for start in range(0, N, TILE):           # 行比 TILE 长:一块一块串行读
        cols = start + tl.arange(0, TILE)
        acc += tl.load(x_ptr + row * N + cols, mask=cols < N, other=0.0)
    tl.store(out_ptr + row, tl.sum(acc, axis=0))  # 最后只做一次跨线程归约

def row_sum(x, TILE=1024):
    M, N = x.shape
    out = torch.empty(M, device=x.device, dtype=x.dtype)
    row_sum_kernel[(M,)](x, out, N, TILE=TILE)
    return out
softmax 不能直接这样分块:要先知道整行的最大值才能算 exp,而最大值要读完整行才知道。边读边更新最大值、同时修正已经算好的部分和,就是 online softmax,FlashAttention 那篇会讲。
前面三个例子里每个数只读一次,分块只是为了把工作分给不同的 program。矩阵乘不同:A 的每个元素要和 B 的一整列相乘,分块是为了让读进片上的数据被多次使用。
2.4 Matmul:分块乘加,顺手融合 ReLU#
矩阵乘按输出 C 分块,一个 program 负责 C 的一个 BM × BN 块,grid 是二维的(图 2-4)。program 沿 K 方向每次读 A 的一个 BM × BK 块和 B 的一个 BK × BN 块,用 tl.dot 乘加到累加器上。写回之前在 register 里做 ReLU,激活函数就不需要单独一个 kernel 再读写一遍 C:
@triton.jit
def matmul_relu_kernel(a_ptr, b_ptr, c_ptr, M, N, K,
                       sam, sak, sbk, sbn, scm, scn,
                       BM: tl.constexpr, BN: tl.constexpr, BK: tl.constexpr):
    pid_m, pid_n = tl.program_id(0), tl.program_id(1)   # 负责 C 的第 (pid_m, pid_n) 块
    rm = pid_m * BM + tl.arange(0, BM)
    rn = pid_n * BN + tl.arange(0, BN)
    rk = tl.arange(0, BK)
    a_ptrs = a_ptr + rm[:, None] * sam + rk[None, :] * sak  # [BM, BK] 的指针
    b_ptrs = b_ptr + rk[:, None] * sbk + rn[None, :] * sbn  # [BK, BN] 的指针
    acc = tl.zeros([BM, BN], dtype=tl.float32)
    for k in range(0, K, BK):                 # 沿 K 一块一块乘加
        a = tl.load(a_ptrs, mask=(rm[:, None] < M) & (rk[None, :] + k < K), other=0.0)
        b = tl.load(b_ptrs, mask=(rk[:, None] + k < K) & (rn[None, :] < N), other=0.0)
        acc += tl.dot(a, b, input_precision="ieee")  # fp32 默认会走 tf32,这里要求精确的 fp32
        a_ptrs += BK * sak
        b_ptrs += BK * sbk
    acc = tl.maximum(acc, 0.0)                # ReLU 在 register 里做完,不多一次读写
    c_ptrs = c_ptr + rm[:, None] * scm + rn[None, :] * scn
    tl.store(c_ptrs, acc, mask=(rm[:, None] < M) & (rn[None, :] < N))

def matmul_relu(a, b, BM=64, BN=64, BK=32):
    M, K = a.shape
    _, N = b.shape
    c = torch.empty((M, N), device=a.device, dtype=torch.float32)
    grid = (triton.cdiv(M, BM), triton.cdiv(N, BN))
    matmul_relu_kernel[grid](a, b, c, M, N, K, *a.stride(), *b.stride(), *c.stride(), BM=BM, BN=BN, BK=BK)
    return c
fp32 输入时 tl.dot 默认走 tf32 的 Tensor core,结果和 fp32 的矩阵乘差 0.1 左右;要和 PyTorch(关掉 tf32)对上,需要 input_precision="ieee"。
2.5 num_warps:结合 grid 和 op 一起看#
四个例子都用了默认的 num_warps=4,即每个 program 4 个 warp。每个 SMSP 实际驻留几个 warp,还要看一个 SM 上同时放了几个 program:每个 SMSP 的 warp 数 = 每个 SM 驻留的 program 数 × num_warps ÷ 4。一个 SM 能驻留几个 program,取决于 grid 够不够分(program 总数 ÷ 170),以及表 1-2 的几条上限。需要驻留几个 warp,则由 op 决定。下面先看 op 需要几个 warp,再看 grid 和 num_warps 怎么凑出这个数。
需要几个 warp,取决于每个 warp 要等多久。以 FMA(fused multiply-add,一条指令算 a × b + c,记 2 次浮点运算)为例:一条 FMA 大约 4 拍后才出结果,如果下一条要用这个结果,就得等它出来才能发。一个 SMSP 上只有 1 个 warp(A)时,4 拍里只有 1 拍在发指令;有 4 个 warp(A、B、C、D)时,A 等待的 3 拍由 B、C、D 填上,每一拍都有指令可发:
拍:          1  2  3  4  5  6  7  8
只有 A:      A  .  .  .  A  .  .  .     用了 1/4 的拍
A、B、C、D:  A  B  C  D  A  B  C  D     每拍都在发
所以要几个 warp,就看等待有几拍,要让别的 warp 把这几拍填满。图 2-5 在 5090 上验证了这一点。kernel 把 256 MiB 数组的每个元素读进来,连做 K 次 FMA(每次都用上一次的结果),再写回。K 越大 intensity 越高,四个 K 让 intensity 从 0.25 到 128,最后一个超过了 ridge point 58,是 compute-bound。grid 固定为 170 × m 个 program,每个 SMSP 就正好驻留 m 个 warp。
compute-bound 的那条线(I = 128)和上面的推算一致:1 个 warp 时是 25%,正好 1/4;4 个 warp 时到 92%。memory-bound 的三条线等的是显存,一次读要几百拍,按说要更多 warp 才能填满;但显存每秒能送的数据有上限,warp 多到把显存喂满以后,再加也没用,实测在 5、6 个 warp 时持平。
反例是 2.4 节的矩阵乘。它每个 SM 只放得下 3 个 block(shared memory 先到上限),每个 SMSP 只有 3 个 warp,照样跑到 5.2e13 FLOPS,是 fp32 峰值的一半。因为一个线程负责很多个输出,这些 FMA 互不依赖,第 2 条不用等第 1 条的结果,一个 warp 自己就能每拍发一条:
拍:          1  2  3  4  5  6  7  8
矩阵乘的 A:  A  A  A  A  A  A  A  A     每条 FMA 互不依赖
知道了要几个 warp,再看 grid 和 num_warps 能不能凑出来。拿 2.3 节的 row sum 试两种形状,元素总数一样(都是 340 MiB),每个线程每轮都读 4 个数,只改 num_warps:
num_warps 下的耗时| 形状 | 每个 SM 分到的 program | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|---|
| 170 × 524288 | 1 | 439 µs | 232 µs | 214 µs | 213 µs | 212 µs | 211 µs |
| 10880 × 8192 | 64 | 212 µs | 212 µs | 211 µs | 211 µs | 211 µs | 217 µs |
表头的 1 到 32 是 num_warps。TILE = 128 × num_warps,每个线程每轮读 4 个 fp32。
170 行时 grid 只有 170 个 program,每个 SM 只分到 1 个,每个 SMSP 的 warp 数就是 num_warps ÷ 4:取 1 时 4 个 SMSP 里只有 1 个有活,439 µs;取 4 以上每个 SMSP 都有 warp,降到 214 µs,带宽 1.67e12 B/s。10880 行时 program 远多于 SM,每个 SM 都塞到上限,num_warps 只改变同样多的 warp 怎么分组,6 种取值都是 211 到 217 µs。
num_warps 还决定每个线程要存多少数据:program 一次要存的数据平分给它的线程。2.2 节的 softmax 把一整行放在 register 里,行长 32768 时,num_warps=1 每个线程要存 1024 个数,远超每个线程 255 个 register 的上限,溢出到显存,耗时 705 µs;num_warps=8 每个线程存 128 个,不溢出,183 µs。
驻留 warp 数与上限之比叫 occupancy,Nsight Compute 会直接报出来。它不必占满,够把等待的拍数填满就行:图 2-5 的 kernel 4 到 6 个 warp 就够,矩阵乘 25% 的 occupancy 也够。调 num_warps 的顺序是:先看 program 比 SM 多多少,program 少时把 num_warps 调大;再看 register 会不会溢出;最后用 triton.autotune 微调。
第 2 节的四个例子是同一个模式:program 把一块数据读进 register,在片上做完能做的计算,再写回显存。下一篇在 5090 上拆解一步训练的时间和显存,用的就是这个模式:把 RMSNorm 的几个 kernel 融合成一个,少读写一遍中间结果。
附录 A TPU:更大的矩阵单元,更简单的控制#
正文的 GPU 靠 kernel 自己分块来复用数据。TPU 面对同样的带宽问题,思路是把控制逻辑做轻,把矩阵乘单元做大。图 A-1 是 TPU v5p 的一个 TensorCore:Scalar unit 取指令、发给 VPU 和 MXU,整个核只有这一路控制,没有 warp 和调度器之间的切换;VPU 做逐元素运算和归约;矩阵乘交给 4 个 MXU,每个是 128 × 128 的 systolic array。片上存储只有 VMEM 和 VREG 两层,VMEM 是编译器管理的 scratchpad,不是硬件 cache,数据什么时候从 HBM 搬进来、搬多少,都由编译器(XLA)提前排好。
MXU 和 GPU 最大的不同在乘加单元怎么拿到数据(图 A-2)。GPU 上每个 CUDA core 做一次乘加,要从 register file 读两个数、写回一个;一个数被用很多次,得靠 kernel 自己分块,先搬进 shared memory 和 register 再反复读,2.4 节的 matmul 就是这样写的。systolic array 把复用做进了硬件:权重先装进 128 × 128 个格子,固定不动;输入 x 从左边进入,每拍向右传一格,经过的每一格把它乘上自己的权重,加到从上面传下来的部分和上,再把部分和往下传。一个 x 从 VMEM 读一次,在一行里被 128 个格子用到;稳定以后每拍从左边进 128 个数、从底部出 128 个结果,阵列里同时做 16384 次乘加,中间结果都不经过 register file。
代价是形状要规整。矩阵的维度要是 128 的倍数才能填满阵列,小矩阵和不规则的计算会浪费格子;数据流由编译器提前排好,也不能像 GPU 那样靠切换 warp 应付不确定的访存延迟。多卡之间怎么互联是另一个大区别,超出了本文的范围。两边术语的对应见表 A-1。
| GPU | TPU | 作用 | RTX 5090 | TPU v5p |
|---|---|---|---|---|
| SM | TensorCore | 包含其他运算单元的核心 | 170 | 2 |
| warp 调度器 | VPU | SIMD 向量运算的调度 | 680 | 8 |
| CUDA core | VPU ALU | 普通的 SIMD 运算单元 | 21760 | — |
| L1 / shared memory | VMEM | 片上的快速存储 | 21.3 MB | 128 MB |
| register | VREG | vector register | 42.5 MB | 512 KB |
| Tensor core | MXU | 矩阵乘单元 | 680 | 8 |
| 显存 | HBM | 大容量主存 | 32 GB GDDR7 | 95 GB |
RTX 5090 的片上存储是 170 个 SM 加起来的总量。TPU 一列参考 Google 的 How to Scale Your Model。
References#
- Gholami, Yao, Kim, Hooper, Mahoney, Keutzer. AI and Memory Wall. IEEE Micro, 2024. 图 1-1。
- NVIDIA. NVIDIA RTX Blackwell GPU Architecture(白皮书)。RTX 5090 的存储层级和 SM 结构,图 1-2、图 1-3。
- NVIDIA. NVIDIA A100 Tensor Core GPU Architecture、NVIDIA H100 Tensor Core GPU Architecture、NVIDIA Blackwell Architecture。表 1-1 的 A100、H100、B200 一列。
- NVIDIA. CUDA Programming Guide。各 compute capability 每 SM 的 warp、block、register 和 shared memory 上限,表 1-2,CUDA 执行层级。
- NVIDIA. Nsight Compute Kernel Profiling Guide。warp 调度状态和 occupancy。
- Austin et al. How to Scale Your Model, Google DeepMind, 2025. 附录 A 的 TPU v5p 规格、systolic array 的数据流和表 A-1。
- Jouppi et al. In-Datacenter Performance Analysis of a Tensor Processing Unit. ISCA 2017. 第一代 TPU 和它的 systolic array。
- Kung. Why Systolic Architectures?. IEEE Computer, 1982.
- Tillet, Kung, Cox. Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations. MAPL 2019.
- Triton tutorials。第 2 节 softmax 和 matmul 例子的写法。
- Hendrycks, Gimpel. Gaussian Error Linear Units (GELUs). arXiv:1606.08415, 2016. 第 2.1 节的 tanh 近似。
- Milakov, Gimelshein. Online normalizer calculation for softmax. arXiv:1805.02867, 2018. 第 2.3 节提到的 online softmax。